Vazamentos & Privacidade
IPED da Polícia Federal: hashes, timeline e perícia digital
Conheça o IPED desenvolvido por peritos da Polícia Federal: processamento, hashes, contêineres, carving e timeline, com código real e exemplos didáticos.
A Polícia Federal brasileira desenvolve uma ferramenta que merece espaço em qualquer conversa séria sobre perícia digital: o IPED. Seu trabalho é transformar grandes conjuntos de evidências em um caso pesquisável, conservando referências aos itens analisados. O interesse técnico está no percurso entre bytes, objetos extraídos, índice e interpretação.
O repositório oficial do IPED apresenta o projeto como software aberto, implementado em Java e desenvolvido por peritos da Polícia Federal desde 2012, com publicação oficial do código em 2019. A ferramenta pode ser utilizada em exames de evidências digitais e investigações corporativas. Esta matéria examina mecanismos públicos e propõe um laboratório com dados fictícios.
O que o IPED faz e onde começa a responsabilidade do examinador
Processar uma evidência é diferente de obtê-la. Um índice não concede acesso a um dispositivo bloqueado nem substitui a aquisição documentada. O examinador precisa saber o que recebeu, como o material foi produzido, qual é o escopo do exame e quais limitações existem. Uma imagem, uma exportação de aplicativo e um conjunto de arquivos não oferecem necessariamente a mesma visão do sistema original.
Esse cuidado combina com o guia NIST SP 800-86 sobre técnicas forenses e resposta a incidentes, que organiza coleta, exame, análise e relato como atividades relacionadas, mas distintas. Um achado produzido durante o exame ainda precisa ser contextualizado. O guia é uma referência técnica; não determina sozinho a admissibilidade de uma evidência em um processo brasileiro.
No IPED, o conjunto de recursos inclui processamento em lote, formatos de imagem forense, expansão de contêineres, hashes, visualizadores, timeline, marcações e relatórios. O uso dessas capacidades deve seguir uma pergunta de investigação definida. Ativar todos os módulos sem critério pode consumir mais recursos e ampliar a exposição de dados sem melhorar a resposta procurada.
Dos bytes ao índice: cada transformação precisa de proveniência
Entrada autorizada e identificada
        ↓
Decodificação da imagem ou estrutura de arquivos
        ↓
Itens e relações com seus contêineres
        ↓
Hashes, identificação e extração de conteúdo
        ↓
Índice de conteúdo e metadados
        ↓
Pesquisa, revisão, marcação e relatório
Este é um desenho explicativo do processamento, não a promessa de uma ordem fixa para todos os módulos internos. Sua utilidade é mostrar onde dados derivados aparecem. Um anexo extraído de um e-mail é um novo item de análise, mas continua ligado ao objeto que o continha. Uma miniatura serve à visualização; não deve ser confundida com o arquivo original.
Pense no índice como uma representação preparada para busca. A ausência de uma palavra no índice pode decorrer de um parser que não extraiu aquele trecho, de formato não reconhecido ou de uma opção do perfil. Um resultado negativo só é interpretável quando as condições de processamento também são conhecidas.
HashTask: um pequeno trecho real mostra o processamento incremental
O arquivo público HashTask.java permite observar como o projeto atualiza os digests enquanto lê a evidência. Um pequeno trecho autêntico é:
digestMap.get(algo).update(currHashBuf, 0, currLen);Esse trecho pertence ao código do IPED, distribuído sob sua licença GPL. Ele atualiza o digest escolhido com a parte válida do buffer, começando no deslocamento zero. O tamanho lido importa: incluir bytes restantes de uma leitura anterior alteraria o hash. O arquivo completo também trata configuração, finalização e erros; esta linha isolada não é uma implementação completa da tarefa.
Uma consequência útil para o laboratório é que o hash não depende de carregar todo o item na memória. A implementação didática abaixo, escrita para esta matéria, demonstra a mesma propriedade com a biblioteca padrão do Python. Ela não foi extraída do IPED e não processa uma imagem forense.
from hashlib import sha256
from io import BytesIO

def digest_em_blocos(fluxo, tamanho=4096):
    if tamanho <= 0:
        raise ValueError('bloco inválido')
    digest = sha256()
    while True:
        bloco = fluxo.read(tamanho)
        if not bloco:
            break
        digest.update(bloco)
    return digest.hexdigest()

conteudo = b'evidencia-ficticia\x00' * 1000
esperado = sha256(conteudo).hexdigest()
assert digest_em_blocos(BytesIO(conteudo), 7) == esperado
assert digest_em_blocos(BytesIO(conteudo), 4096) == esperado
assert digest_em_blocos(BytesIO(conteudo + b'x')) != esperado
print('hash estável por blocos e alteração detectada')
Os dois primeiros controles mudam apenas o tamanho do bloco. O terceiro muda a entrada. Esse par de testes diferencia uma propriedade da implementação de uma propriedade do conteúdo. O digest ajuda a comparar bytes; ele não informa quem criou o arquivo, quando houve a criação ou se a história de custódia foi bem documentada.
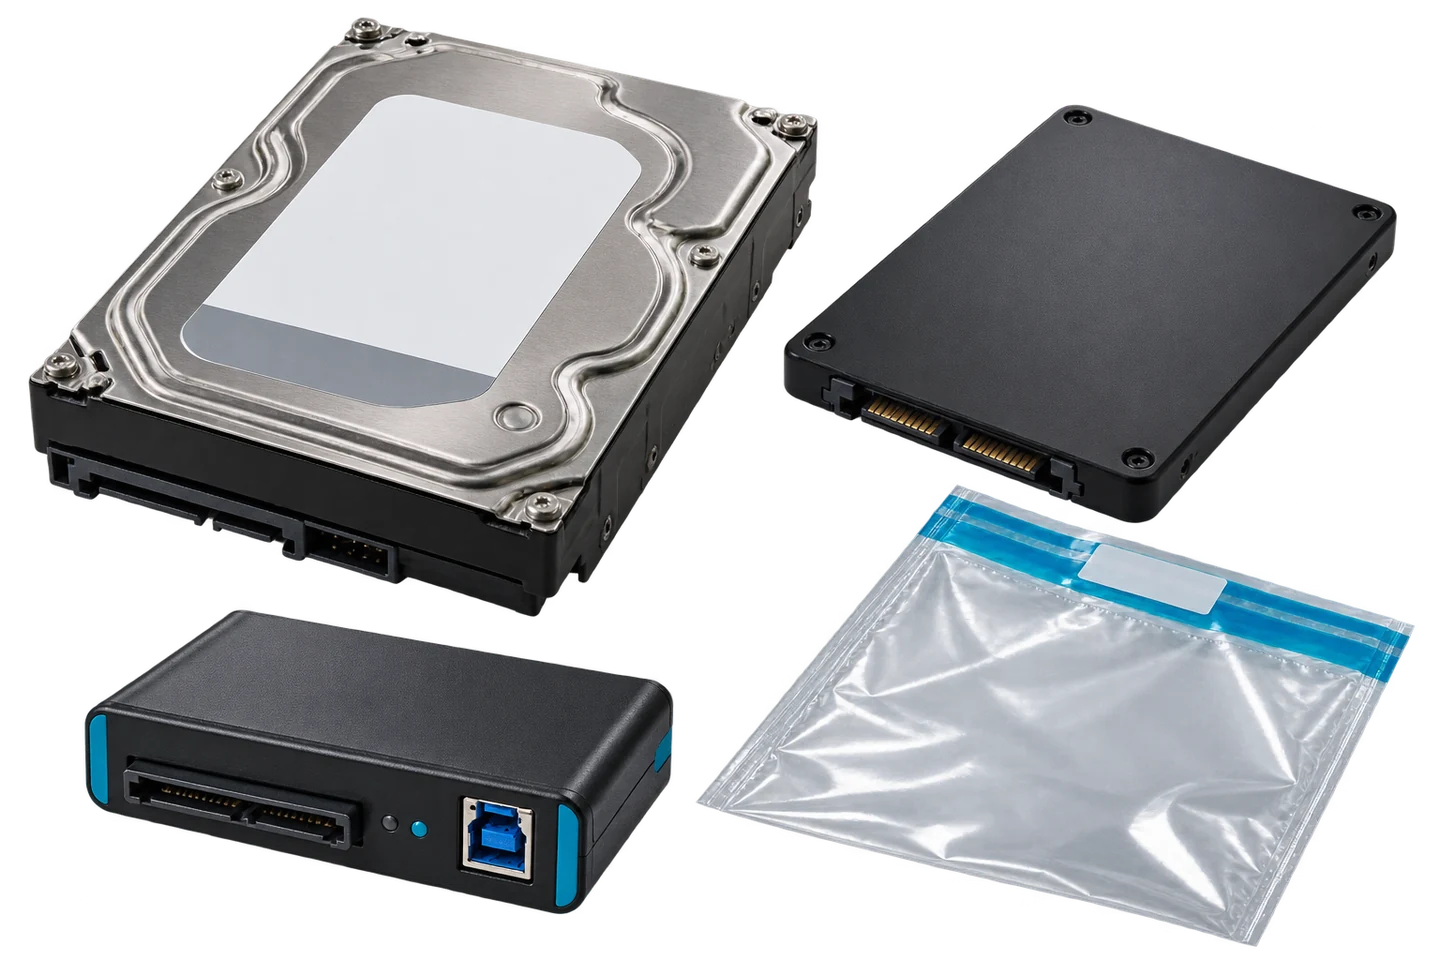
Ilustração gerada de mídias e recursos genéricos de preservação. IPED é software de análise; integridade da aquisição, bloqueio de escrita quando aplicável e cadeia de custódia são responsabilidades separadas do exame do conteúdo.
Duplicação de conteúdo não elimina a importância da ocorrência
Dois itens podem ter o mesmo hash e aparecer em lugares diferentes. Uma cópia em uma pasta, outra dentro de um arquivo compactado e uma terceira em um anexo representam ocorrências distintas. Economizar trabalho sobre o conteúdo não deve apagar o caminho que explica por que aquele item apareceu na análise.
O desenho de um relatório precisa separar identidade do conteúdo e referência da ocorrência. O primeiro pode usar um digest; a segunda precisa conservar caso, origem, contêiner e localização dentro da entrada. Agrupar por hash é uma operação de apresentação. Descartar todas as ocorrências duplicadas pode remover contexto relevante.
| Objeto | Identidade útil | Contexto a preservar |
|---|---|---|
| Conteúdo do arquivo | Digest e comprimento | Método de obtenção e versão do processamento |
| Ocorrência | Referência única do item | Caminho, contêiner e fonte |
| Texto extraído | Referência à transformação | Parser, erro e eventual truncamento |
| Evento temporal | Item e campo de origem | Fuso, semântica e precisão |
| Marcação do examinador | Responsável e instante | Critério e justificativa |
Perfis e carving: ausência de resultado depende da configuração
O manual oficial distingue o perfil default do forensic. O primeiro inclui recursos como hashing, identificação, expansão e indexação; o segundo acrescenta processamento de espaço não alocado, slack e carving, entre outras opções. Verifique o perfil efetivo da distribuição utilizada e os requisitos de cada módulo, em vez de inferi-los apenas pelo nome do caso.
Carving procura estruturas recuperáveis nos bytes. Um objeto recuperado pode não conservar o nome original, o diretório ou todos os metadados. Um fragmento que parece imagem também pode estar truncado. No relatório, marque essa condição e mantenha a localização de origem. Encontrar dados não significa automaticamente reconstruir toda a história do arquivo.
Um experimento simples compara o mesmo conjunto de entrada com dois perfis, guardando as configurações de ambos. Liste itens adicionais, erros e tempo gasto. Se o objetivo é avaliar recuperação, inclua uma estrutura conhecida e um controle negativo. Sem resultado esperado, a comparação vira apenas uma disputa pelo maior número de itens.
Um começo reproduzível no laboratório
O guia inicial do IPED apresenta o uso de -d para a entrada e -o para o caso. A saída deve não existir ou estar vazia. Em Linux, o guia orienta a execução via Java. Os comandos abaixo exemplificam um caso com uma imagem de laboratório válida preparada previamente, não um dispositivo real de terceiro.
Windows:
iped.exe -d laboratorio.dd -o caso-iped -profile default

Linux:
java -jar iped.jar -d laboratorio.dd -o caso-iped -profile default
Baixe uma distribuição estável pelos canais oficiais e registre sua versão. Mantenha entrada, caso e área temporária identificados. Para comparar duas execuções, use saídas separadas e conserve configurações e logs. Não misture resultados de versões ou perfis diferentes como se tivessem sido produzidos pelo mesmo procedimento.
O projeto não foi executado integralmente no ambiente de preparação desta matéria. Os exemplos Python foram testados com fixtures locais; os comandos IPED foram conferidos na documentação. Essa diferença evita apresentar um roteiro reproduzível como uma perícia efetivamente realizada.
Timeline: UTC ajuda a ordenar, mas não corrige um relógio ruim
Uma linha do tempo profissional guarda o valor original e a interpretação aplicada. Horário de criação, última modificação, evento do aplicativo e instante de exportação são coisas diferentes. Converta para uma referência comum quando o fuso é conhecido, sem apagar a origem. Um horário sem fuso não deve ganhar UTC silenciosamente.
from datetime import datetime, timezone

def normalizar_horario(valor):
    instante = datetime.fromisoformat(valor)
    if instante.tzinfo is None:
        raise ValueError('horário sem fuso explícito')
    return instante.astimezone(timezone.utc).isoformat()

a = normalizar_horario('2026-10-14T09:00:00-03:00')
b = normalizar_horario('2026-10-14T12:00:00+00:00')
assert a == b
try:
    normalizar_horario('2026-10-14T09:00:00')
except ValueError:
    print('fuso ausente mantido como problema, sem suposição')
else:
    raise AssertionError('horário ambíguo deveria falhar')
Esse modelo original valida uma representação temporal, não a veracidade do relógio do dispositivo. Dois eventos próximos podem ter relação, coincidência ou diferença de relógios. Para sugerir causalidade, confronte o tipo do evento, seus identificadores e outras fontes. Mantenha hipóteses alternativas quando os dados não permitem decidir.
OCR, buscas e falsos positivos precisam de revisão humana
Um laboratório de busca deve conter exemplos positivos, negativos e variações de grafia. Faça a mesma procura em texto simples, imagem e documento com texto extraível, registrando quais módulos atuaram. Dessa forma é possível distinguir falha de configuração, limite da extração e diferença na consulta.
A classificação automática deve funcionar como auxílio à revisão. Uma expressão regular parecida com uma carteira de criptomoeda não comprova titularidade. Uma palavra reconhecida em uma imagem pode ser erro de leitura. Um documento semelhante pode compartilhar modelo e não conteúdo relevante. O relatório precisa conservar a evidência mínima que permite verificar o motivo da marcação.
Casos processados também podem conter informações sensíveis. Restringir entrada não basta se o índice, miniaturas, relatórios e cópias temporárias permanecem expostos. Defina quem pode acessar cada artefato e como os resultados selecionados serão exportados. Um relatório destinado ao público deve usar dados de laboratório ou ocultação justificada, preservando o original no contexto autorizado.
O diferencial brasileiro é um mecanismo público que pode ser examinado
O IPED permite discutir engenharia forense com uma implementação disponível, algo diferente de tentar adivinhar a arquitetura de um produto fechado. Código, documentação e experimentos precisam ser lidos juntos: uma função demonstra um mecanismo; um teste demonstra seu comportamento naquele caso; a análise explica como o resultado responde à pergunta inicial.
Para comparar esse cuidado de proveniência com infraestrutura de inteligência, veja HACIENDA e a organização de observações de serviços. Os usos são diferentes, mas resultados confiáveis exigem origem, tempo, contexto e limite de interpretação.
O valor do IPED aparece quando um achado continua verificável depois da pesquisa. Preserve o vínculo com a entrada, a versão das transformações e a explicação da conclusão. Uma lista de hits é o começo do trabalho; um exame reproduzível transforma esses hits em informação técnica defensável.